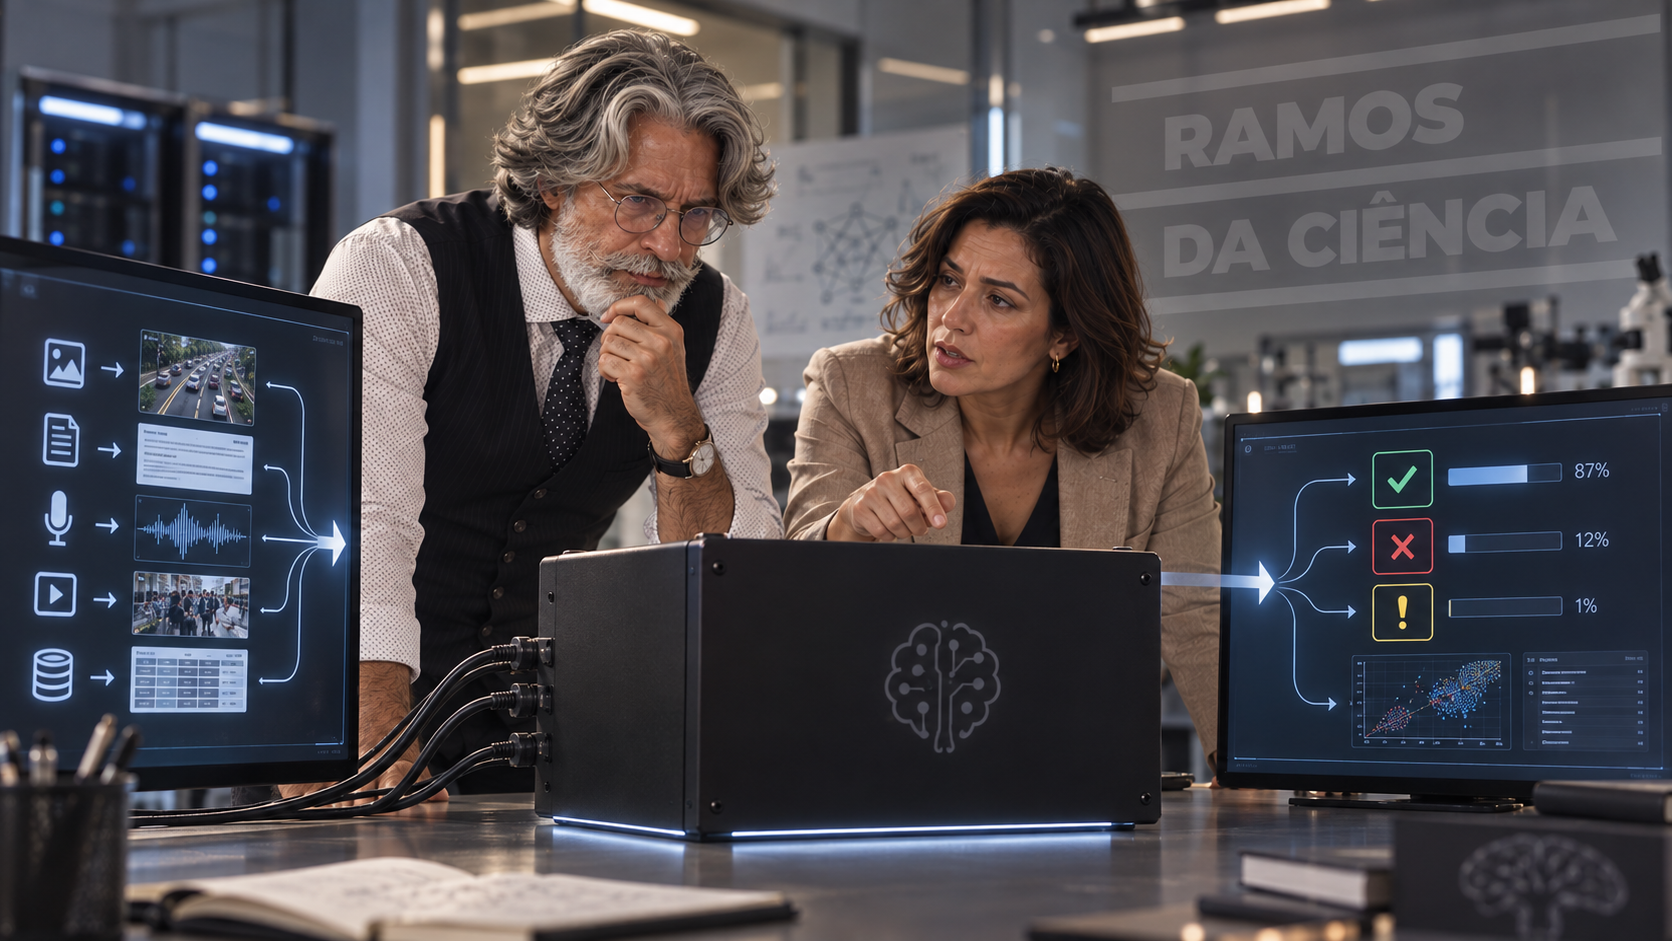
A caixa-preta da IA aparece quando um sistema produz uma previsão, classificação ou resposta útil, mas é difícil reconstruir de forma clara por que aquele resultado surgiu. Nem toda opacidade tem a mesma origem — e essa diferença importa quando decisões afetam pessoas.
SÉRIE · Poder e controle
2 de 6
O que é a caixa-preta da IA?
No texto anterior, vimos que sistemas de IA podem participar da distribuição de atenção, oportunidades e restrições.
Isso cria uma exigência simples: se uma decisão afeta alguém, deveria ser possível entender por que ela aconteceu.
Mas, nem sempre é.
Redes neurais profundas aprendem relações a partir de grandes quantidades de dados e ajustam milhões ou bilhões de parâmetros durante o treinamento.
Quem desenvolve o sistema define arquitetura, dados, objetivos e procedimentos de treinamento. Mas não escreve manualmente cada regra que levará a cada resultado.
O modelo aprende representações internas complexas.
Por isso, uma IA pode produzir uma resposta útil sem que exista uma explicação humana curta e direta para o caminho interno que gerou aquele resultado.
Funcionar bem e explicar bem são pontos bem diferentes.
Nem toda opacidade vem da mesma causa
“Caixa-preta” pode dar a impressão de que existe sempre algum segredo escondido dentro da máquina. Porém, a coisa não é tão simples.
Em um estudo clássico sobre opacidade em algoritmos de machine learning, a pesquisadora Jenna Burrell distinguiu três fontes diferentes do problema:
- sigilo: empresas ou governos podem deliberadamente não revelar informações sobre um sistema;
- especialização técnica: código, estatística e machine learning exigem conhecimento que grande parte das pessoas não possui;
- complexidade do próprio modelo: algumas relações aprendidas são difíceis de traduzir para formas de raciocínio compreensíveis em escala humana.
A distinção é importante porque cada problema exige uma resposta diferente. Abrir o código pode ajudar contra o sigilo.
Porém, isso não resolve necessariamente a complexidade matemática.
Quem criou o modelo também pode não explicar cada saída
Aqui está uma das partes mais contraintuitivas.
Dizer que um desenvolvedor não consegue explicar detalhadamente uma saída não significa que ele não saiba como o sistema funciona.
Ele pode conhecer:
- a arquitetura;
- os dados de treinamento;
- a função de perda;
- os parâmetros;
- os testes;
- as métricas.
Mesmo assim, pode ser difícil responder: por que exatamente esta combinação de sinais produziu este resultado específico?
O problema cresce conforme o modelo incorpora muitas variáveis e relações distribuídas.
A máquina não está escondendo uma justificativa. Pode simplesmente não existir uma regra curta do tipo:
“resultado X ocorreu porque a regra Y foi acionada”.
É por isso que interpretabilidade e explicabilidade se tornaram áreas próprias de pesquisa.
Explicar para quem?
Uma explicação útil também depende de quem pergunta.
O desenvolvedor pode querer saber quais características do modelo pesaram em determinada previsão. Um auditor pode querer verificar vieses. Uma instituição pode precisar justificar uma decisão.
A pessoa afetada talvez só queira saber: por que fui rejeitada?
Essas necessidades não são iguais.
Uma explicação convincente pode estar errada
Esse ponto é especialmente importante na IA generativa. Um modelo de linguagem consegue produzir uma justificativa extremamente clara para quase qualquer resposta.
Mas a capacidade de explicar em linguagem natural não significa que aquele texto descreva fielmente o processo que levou à resposta.
Como vimos em o que é um modelo de linguagem, esses sistemas produzem linguagem a partir de padrões aprendidos.
Portanto, precisamos distinguir: uma explicação produzida pelo modelo de uma explicação do funcionamento do modelo.
As duas coisas podem parecer iguais na tela. Porém, não são.
Por que a explicabilidade importa?
Em muitas situações, talvez não importe saber exatamente por que um sistema recomendou determinada música.
Mas, a exigência muda quando a IA participa de decisões sobre:
- crédito;
- emprego;
- saúde;
- educação;
- segurança.
Nesses casos, uma pessoa pode precisar entender o resultado para corrigi-lo ou contestá-lo.
Explicar não resolve tudo
Mesmo um sistema perfeitamente transparente ainda pode produzir um resultado indesejável.
Ele pode estar fazendo exatamente aquilo para o qual foi otimizado. E aí surge um problema diferente.
Imagine um sistema que recebe um objetivo, aprende a persegui-lo com eficiência e produz consequências que ninguém queria.
O problema já não é: “por que ele fez isso?“ Mas: “ele estava realmente perseguindo aquilo que queríamos?“
Essa é a pergunta que abre o próximo texto.
O que é alinhamento de IA e por que ele é difícil?
PODER E CONTROLE
Próximo: O que é alinhamento de IA e por que ele é difícil?
2 de 6 — A caixa-preta da IA
Anterior: Artefatos têm política? Como a IA distribui poder